ワードクラウドという仕組みがあります。こういうものです。
名前はともかくこういう表示を見たことがある、という方は多いかと思います。
今回、これまでのブログの文章を取得し、ワードクラウドを使って文字列として並べてみました。
使用した環境
- Python 3.14.2
- Visual Studio Code 1.123.0
1. GitHub CopilotのPlanモードで計画を立てる
まずは前回紹介したGitHub CopilotのPlanモードを使って計画を立てました。
以下がプロンプトです。
- ワードクラウドを試してみたいです。自分の書いているブログ記事の文章を取得して、その結果をワードクラウドで表示してみる方法を計画してください。

- 条件は以下の通りです。

- 文章の取得対象はこのURLで紹介されている45個の記事 : https://www.crossroad-tech.com/archive/2016

- この記事は「はてなブログ」で書かれている。はてなブログにはAtomPubを使ったAPIがあるので、AtomPubを使う

- このブログによるAtomPubのルートエンドポイントはこれ:[https://URLを表示]

- AtomPubを使うためのIDとAPIKEYは取得済みなので、ID="AAA”, APIKEY=“BBB”のようにソースコードに記載

- ワードクラウドは日本語、英語のどちらも対応する。なぜなら45個の記事には英語が含まれている可能性があるため
結果、このようなプランを提示してくれました。
はてなブログのAtomPub APIを使って2016年の45個の記事を取得し、日本語・英語両対応のワードクラウドを生成するPythonスクリプトを作成します。AtomPubでエントリー一覧と本文を取得→HTMLタグ除去→形態素解析(日本語はJanome、英語はNLTK)→ワードクラウド生成の流れです。
(省略)

必要なPythonライブラリのインストール設定 (parallel with step 1)

requests: AtomPub API呼び出し
beautifulsoup4: HTMLタグ除去
janome: 日本語形態素解析
nltk: 英語のストップワード処理
wordcloud: ワードクラウド生成
matplotlib: 画像表示
pillow: 画像処理
(省略)
この内容に基づき、370行くらいのPythonスクリプトを作ってもらいました。
なお、Python環境の作り方、はてなブログのAPIの使い方、ワードクラウドの使い方は下記も参照しています。
1回ではてなブログからの記事取得は成功しました。一部のPythonライブラリがインストールされていなかったので少し修正し、15分程度で期待通りの結果になりました。
最終版はこちらです。対象ディレクトリでpython3 blog_wordcloud.pyを実行するだけです。
blog_wordCloud.py · GitHub (開くと、約370行のソースコードが開きます)
なお、どんなライブラリをインストールしたかを示すrequirements.txtはこちらです。
requests>=2.31.0
beautifulsoup4>=4.12.0
janome>=0.5.0
nltk>=3.8.0
wordcloud>=1.9.0
matplotlib>=3.7.0
pillow>=10.0.0
2. 2016-2026年までのワードクラウドの結果
本当は2013年から書いているのですが、初期の記事をかなり消してしまったので、2016年からにしてみました。
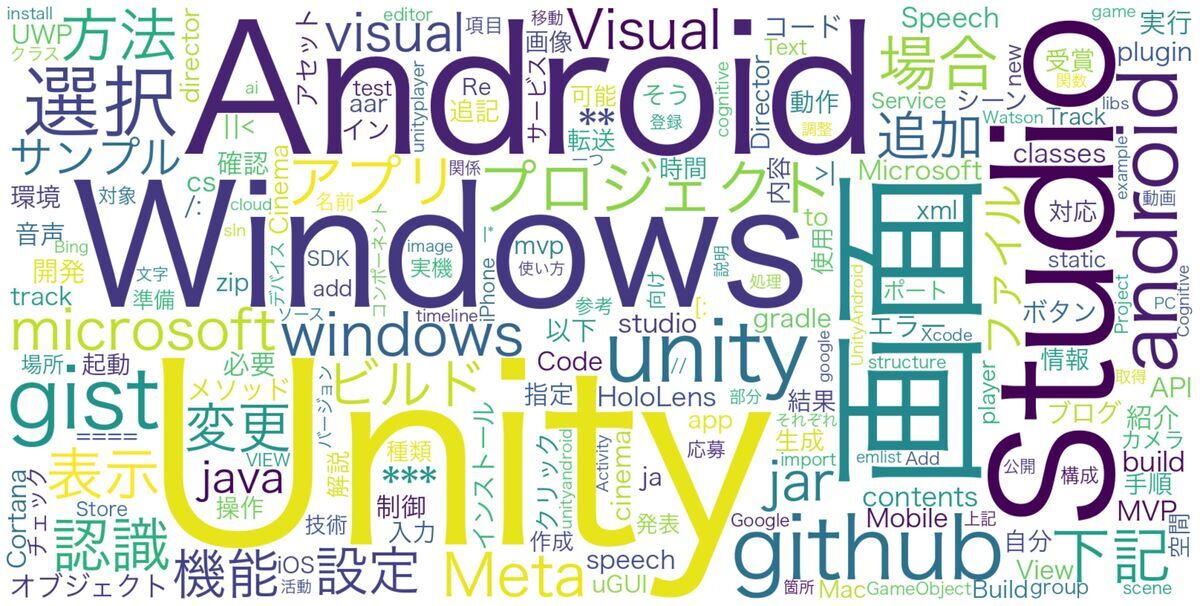
◾️2016
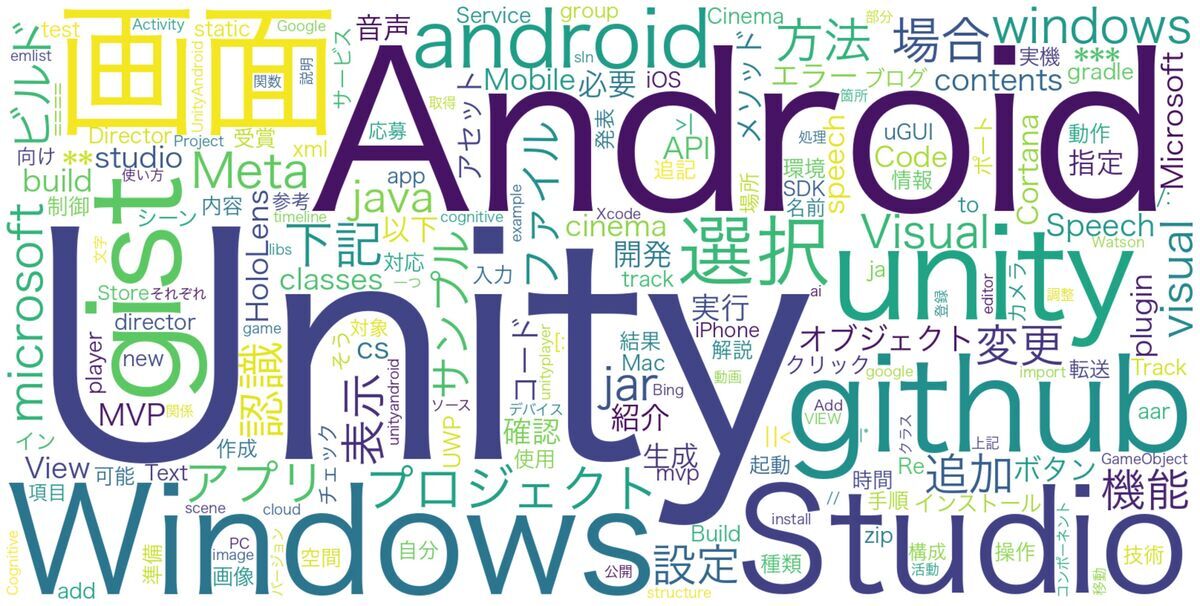
◾️2017
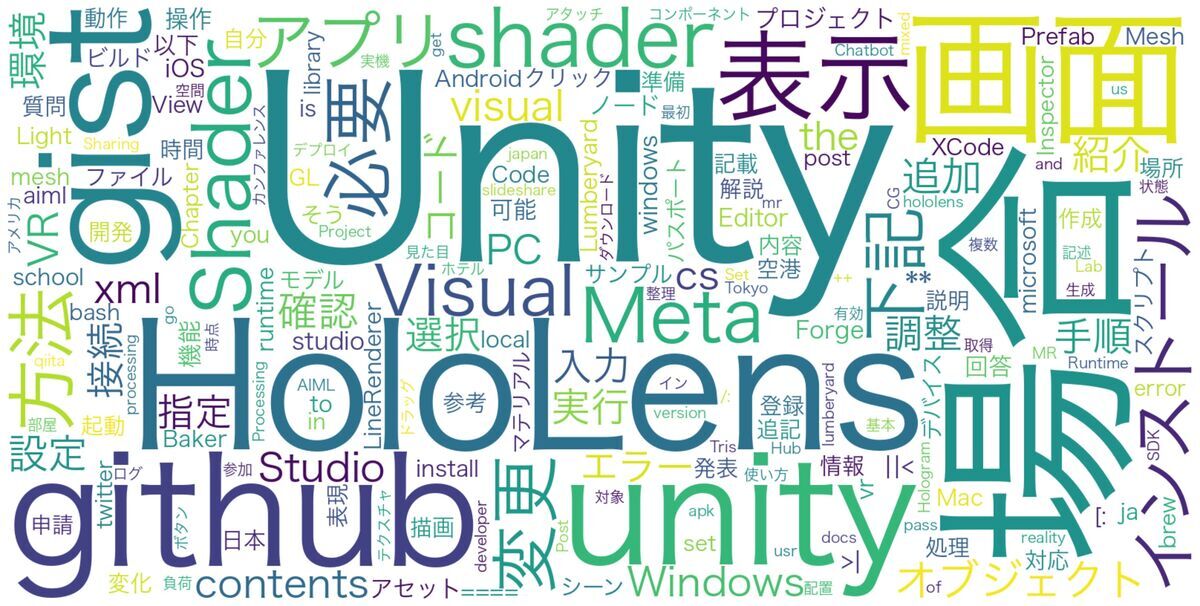
◾️2018
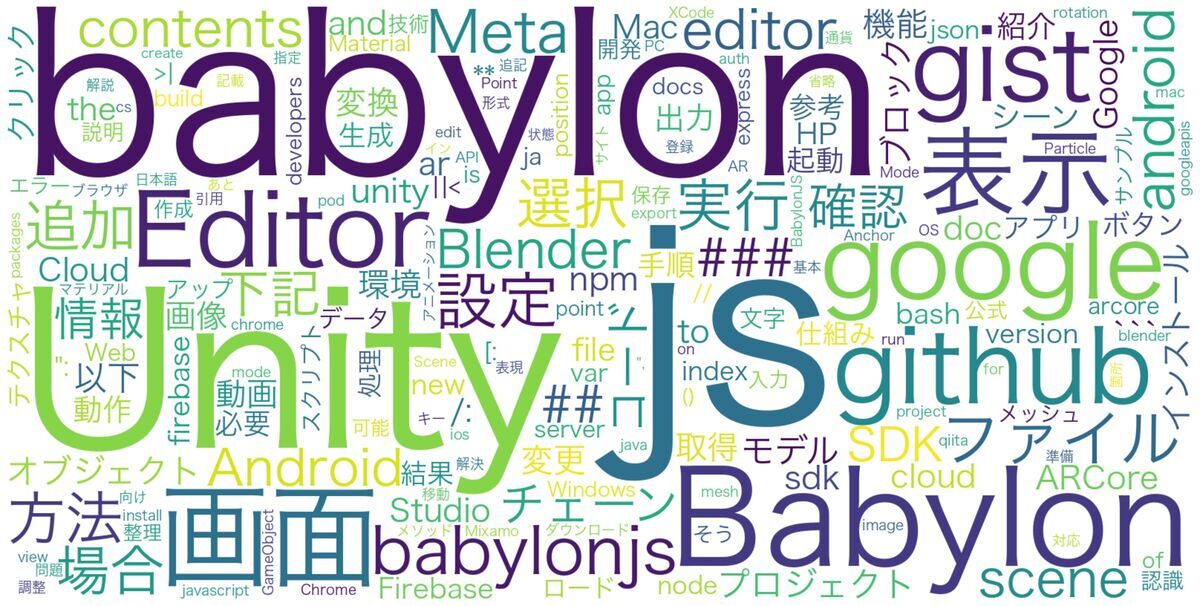
◾️2019
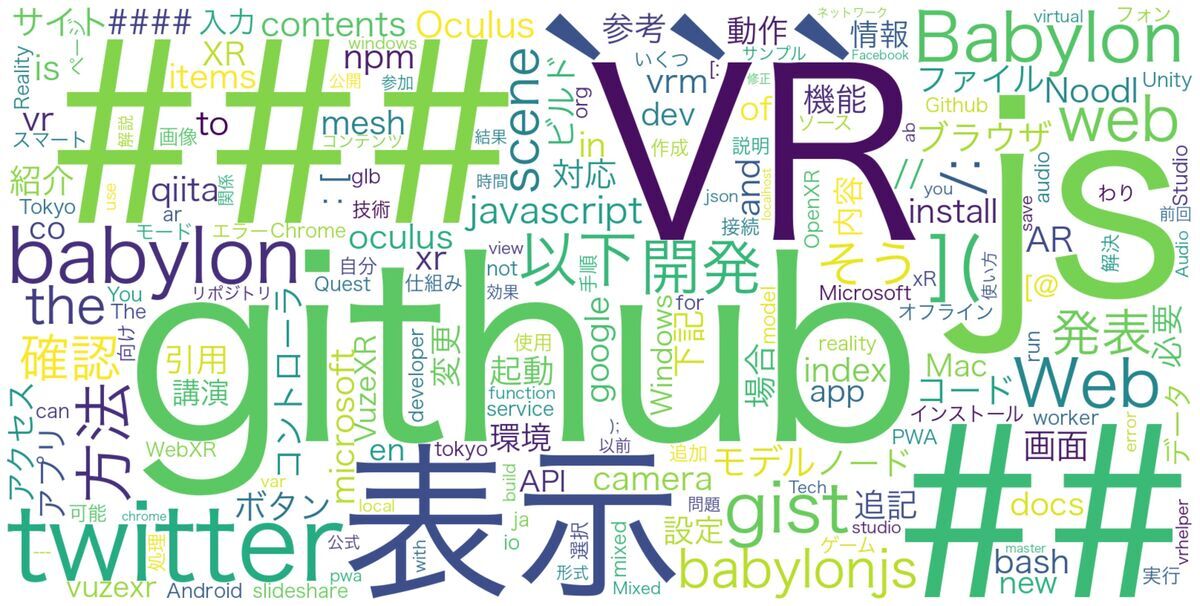
◾️2020
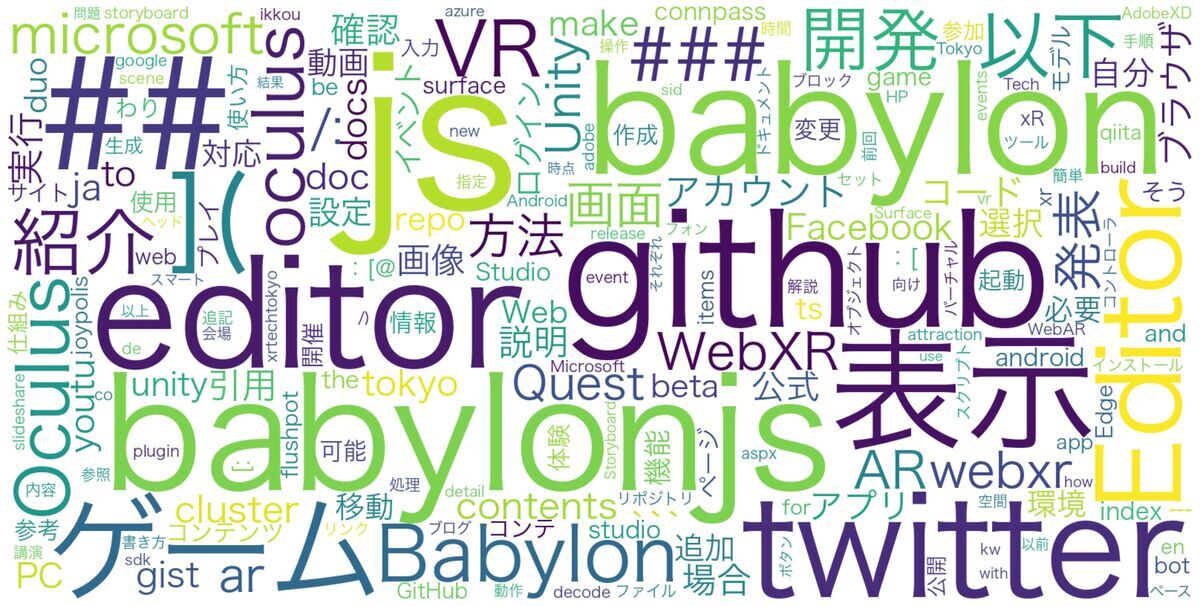
◾️2021
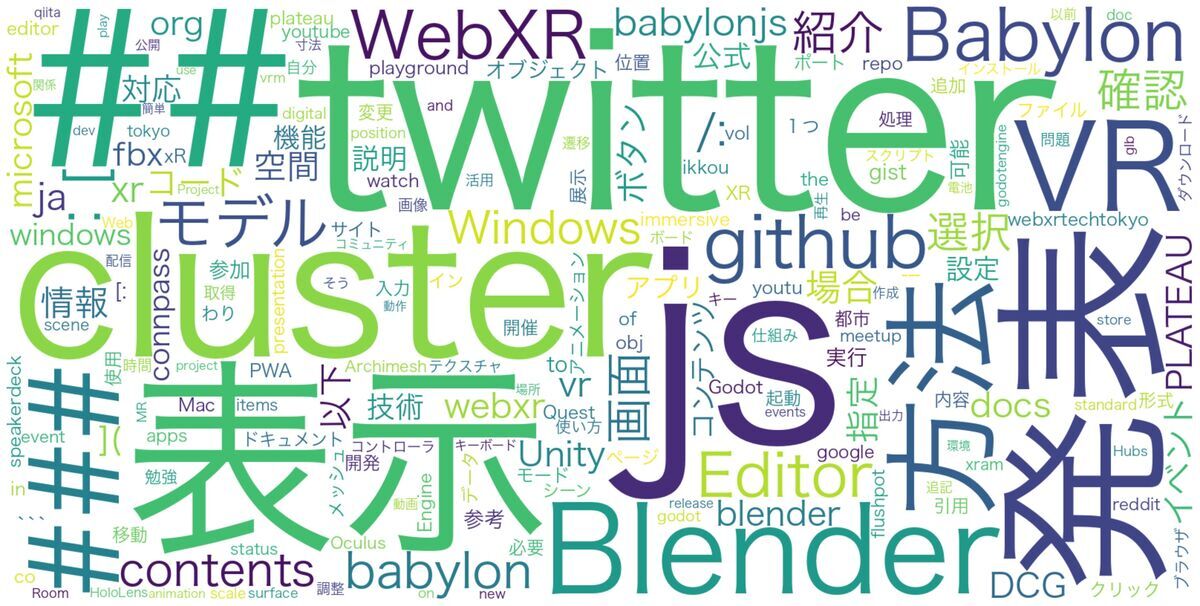
◾️2022
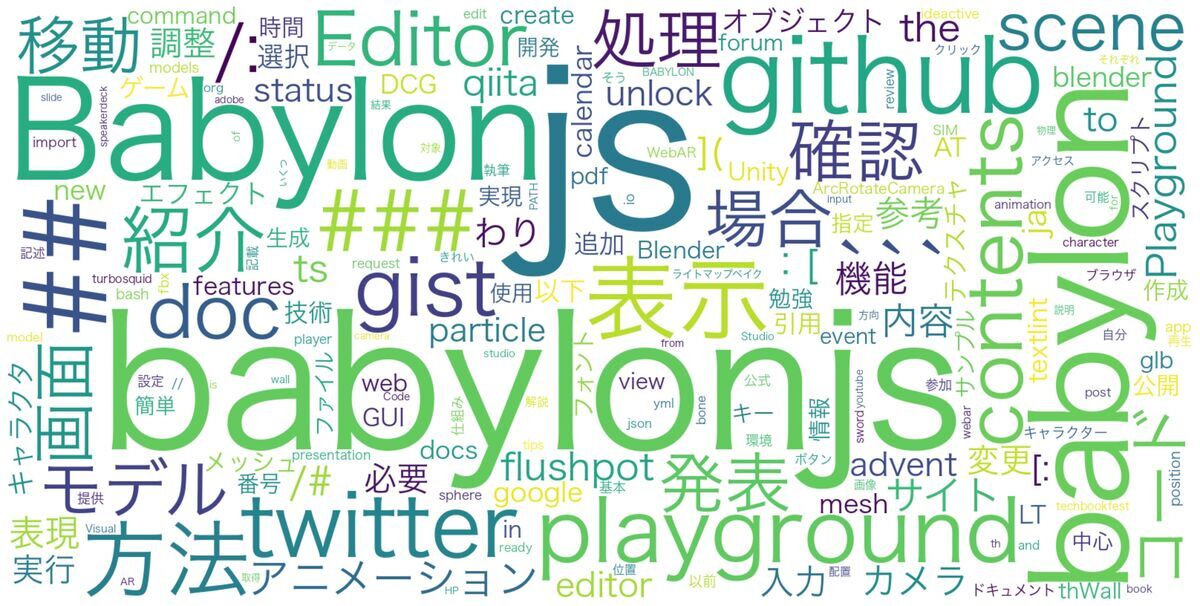
◾️2023
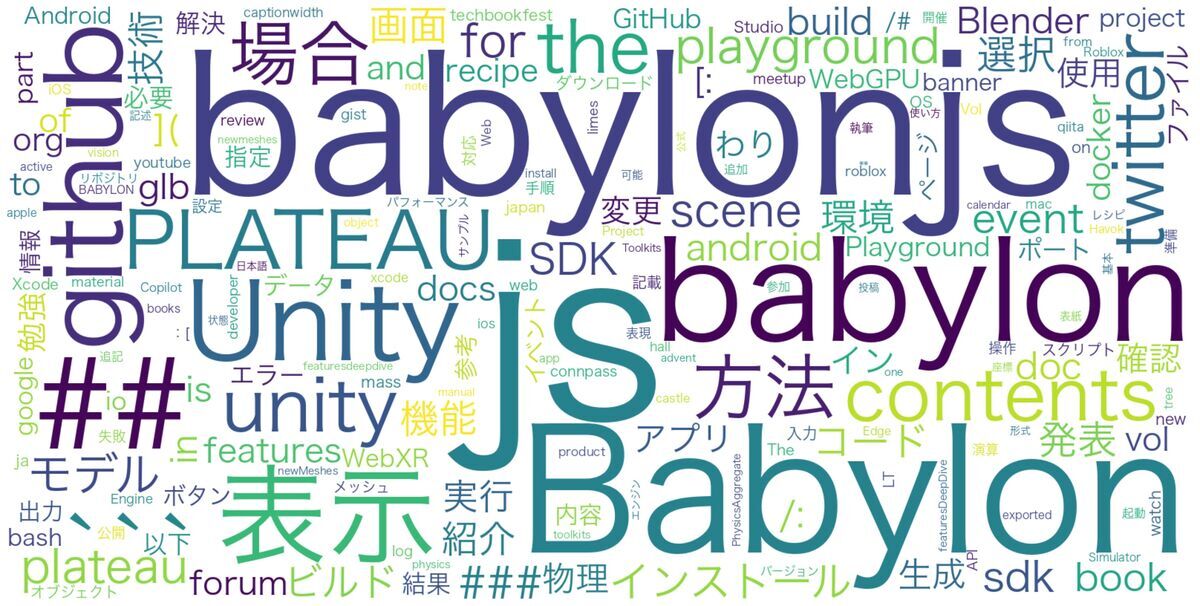
◾️2024
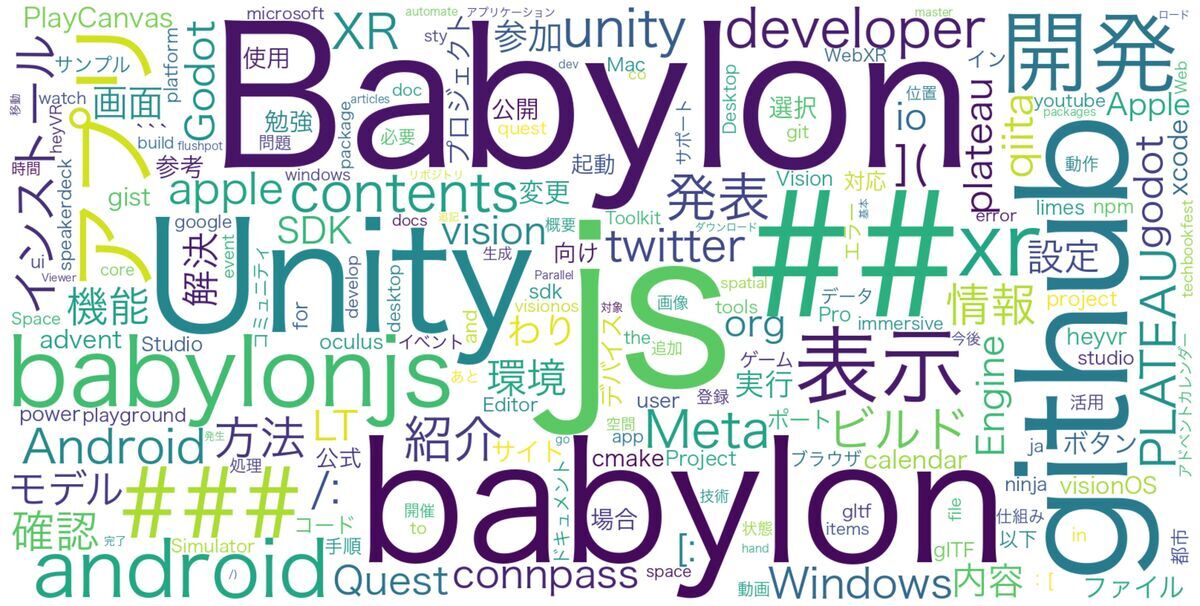
◾️2025
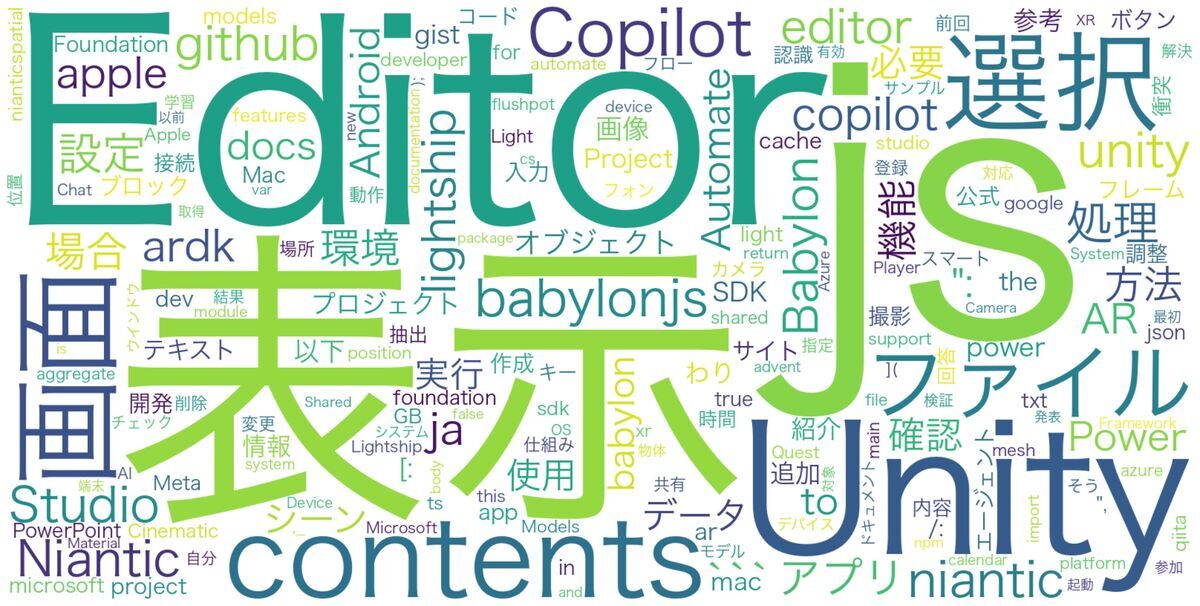
◾️2026
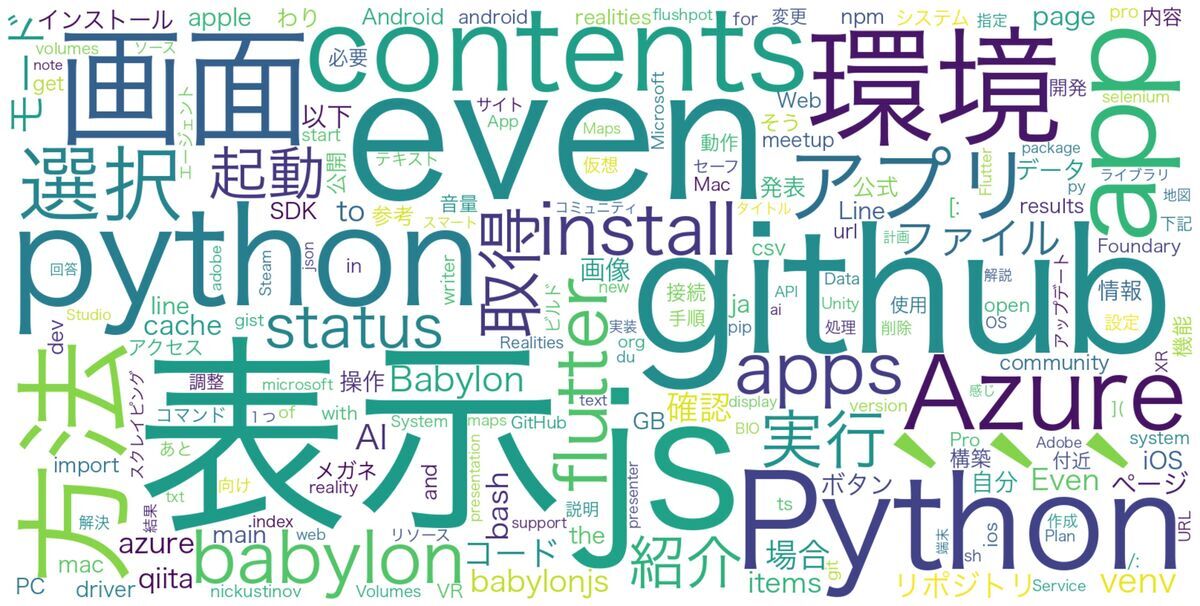
最初はUnity、2018頃からBabylon.js、最近はEven G2やPythonが多くなっていることが確認できます。それは感覚的にも合っているので、記事にある言葉の頻出頻度をよく可視化できていると思います。
3. おわりに
GitHub Copilotのおかげで試したいことがすぐにできました。少し前まではそれなりに調べて試行錯誤だったのですが、片手間でできるようになり、技術の進化を感じます。
今までXRを中心に可視化する側のことが多く、分析や抽出といったデータサイエンス的なことはあまり経験がありませんでした。
今は未経験でもこのように簡単に作れるので、Pythonを使って今までできていなかったことをもう少し試してみたいと思います。
